











 Marc-André Moreau
Nota: questo articolo lungo è stato scritto in origine per la sfida di saggi di The Pragmatic Engineer su come sta cambiando l’ingegneria del software.
Ottobre 2025. Claude Sonnet 4.5 è appena uscito, e tutti in Devolutions stanno seguendo una formazione sull’IA di Mindstone. Il messaggio del CEO è chiaro: stiamo facendo tutti i passi necessari per rendere l’azienda nativa dell’IA. Ai dipendenti che non vogliono far parte di questa nuova «Devolutions 2.0» viene offerto un pacchetto di uscita volontaria. Chi resta deve impegnarsi e puntare tutto sull’IA insieme al resto di noi. Questa è la storia del cambiamento profondo avvenuto in Devolutions, e di come una migrazione importante, stimata all’inizio in tre anni, sia stata completata in uno solo.
Devolutions è un’azienda di software canadese cresciuta con i propri mezzi, con la sede principale a Lavaltrie, in Québec, e oltre 250 dipendenti in tutto il mondo. Il nome «Devolutions» sta per «Development Evolutions», dai tempi in cui il fondatore, David Hervieux, faceva contratti di sviluppo software, molto prima dell’attuale successo commerciale del nostro prodotto di punta, Remote Desktop Manager (RDM). RDM è un gestore di connessioni: si occupa di avviare connessioni con iniezione delle credenziali per protocolli come RDP, SSH, VNC, ARD, PowerShell e altri. Se qualcosa accetta credenziali e si connette, è molto probabile che RDM lo supporti già.
Il mio team è un po’ particolare: include gli sviluppatori della sede di Ottawa, ma anche sviluppatori negli Stati Uniti, in Germania e in Giappone. Internamente lo chiamiamo il team di «architettura», perché siamo responsabili della costruzione di molti componenti riutilizzabili che gli altri team usano. La struttura è molto sciolta, ma ognuno è molto autonomo, motivato e responsabile. La maggior parte dei team in Devolutions lavora in presenza, non da remoto, nella sede principale di Lavaltrie.
Quanto a me, sono il CTO di Devolutions. In una vita precedente ho fondato il progetto FreeRDP. Sono Microsoft MVP nelle categorie Windows e PowerShell. La mia area principale di competenza sono i protocolli Windows, soprattutto per RDP e l’autenticazione. Ho una predisposizione per il reverse engineering e per scavare negli interni dei sistemi. Mi piace sperimentare con la tecnologia per trovare modi di mettere insieme i pezzi del puzzle e costruire i prodotti che vogliamo.
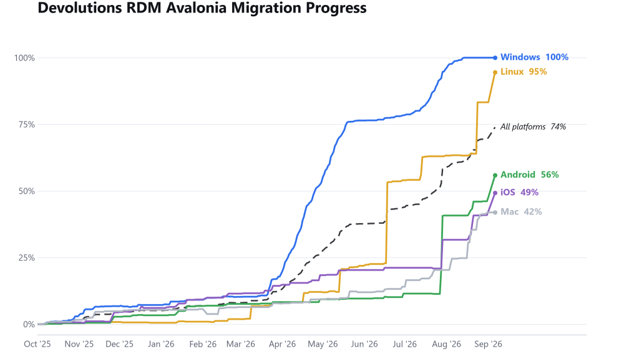
Le applicazioni desktop Windows restano spesso indietro nel mondo dell’IA: gli strumenti più popolari sono usciti prima senza supporto per Windows e, quando finalmente è arrivato, era parziale. Le applicazioni desktop, a differenza delle applicazioni web, sono in forte svantaggio perché è molto più difficile validarle in automatico con l’IA. Nonostante queste difficoltà, siamo riusciti a portare Remote Desktop Manager, un’enorme applicazione aziendale .NET con migliaia di finestre di dialogo, su Avalonia, un framework di interfaccia multipiattaforma, in meno di un anno. Ancora più sorprendente è che la migrazione Windows ha raggiunto il 100 % per prima, davanti ad altre piattaforme con meno debito tecnico.
Comprimere tre anni in uno
Il grande progetto di migrazione ad Avalonia
Siamo un’azienda che mette il desktop al primo posto, e siamo impegnati a fare ottime applicazioni desktop. Per questo sponsorizziamo Avalonia con 3 milioni di dollari in 3 anni. Il motivo è semplice: non vogliamo sacrificare l’esperienza dell’applicazione desktop usando un’applicazione web travestita, come Electron, ma dobbiamo comunque ridurre il carico dello sviluppo migrando a un framework di interfaccia multipiattaforma in .NET. Abbiamo accumulato molto legacy e molte funzioni avanzate nel corso degli anni, quindi non possiamo permetterci di riscrivere tutto su un nuovo framework di interfaccia tra due versioni principali. Prima dell’IA, stimavamo lo sforzo in almeno 3 anni. Avalonia ci ha dato i mezzi per fare una migrazione parziale, così da poter mescolare elementi di interfaccia nativi con Avalonia.
È la migrazione più ambiziosa mai tentata in Devolutions: oltre 1.500 elementi di interfaccia WinForms che risalgono a più di un decennio di lavoro, solo per RDM Windows. Le altre piattaforme hanno molti meno elementi di interfaccia nativi. Nell’ottobre 2025 stavo cercando come usare l’IA per accelerare tutto questo, perché in quel momento la migrazione era ancora per lo più manuale. La prima cosa che ho fatto è stata creare uno script che analizzava i file sorgente del nostro monorepo per registrare il numero di elementi di interfaccia specifici di ogni piattaforma ancora da migrare, a partire dal primissimo commit in cui è stato introdotto Avalonia. Quel numero è diventato la nostra base di riferimento, e ogni piattaforma doveva portarlo a zero rimuovendoli man mano che venivano sostituiti da Avalonia.
Il totale di tutte le piattaforme insieme superava i 5.800 elementi di interfaccia da portare, e a quel punto i progressi erano appena di qualche punto percentuale per ogni piattaforma.
La fase del cannone di slop IA
I primi tentativi di accelerare la migrazione ad Avalonia hanno prodotto molto slop di IA, di cui ero personalmente responsabile per la maggior parte. Per fortuna la frustrazione è stata solo temporanea e, a posteriori, è stato un passo necessario per imparare. Il vero valore della fase del cannone di slop IA è stato dare una sveglia agli sviluppatori che sapevano quello che facevano, perché iniziassero ad aggiungere e migliorare le istruzioni per l’IA, in modo che commettesse meno errori.
Queste erano le difficoltà:
- Io stesso facevo poca interfaccia, quindi non sapevo quello che stavo facendo
- I modelli di IA di un anno fa commettevano molti errori
- L’IA non aveva gli strumenti giusti per vedere il prima e il dopo
RDM supporta molte voci di connessione, soprattutto VPN che gli utenti possono usare come dipendenza di un’altra voce di connessione. Per esempio, si può avere una connessione RDP che avvia in automatico una VPN WireGuard se serve per raggiungere il server RDP associato. Ho deciso di provare a portare prima la voce di connessione VPN, sperando di estrarre abbastanza istruzioni perché l’IA diventasse brava a portare tutte le altre voci VPN. Ci sono voluti un paio di tentativi, e ho dovuto chiedere ai colleghi di aiutarmi a sistemare delle cose su un branch sperimentale. Poi ho aggiornato le istruzioni indicando all’LLM i commit, perché imparasse da quelli. Dopo un paio di iterazioni così, le istruzioni erano abbastanza buone da permettermi di portare in automatico qualche altro tipo di voce VPN, ma richiedevano ancora molte correzioni.
Il processo è diventato semimanuale: avviavo una sessione in cui indicavo all’agente di analizzare ed elencare i successivi tipi di voci VPN più semplici che potevo portare. Ne facevo lotti di 10, poi avviavo RDM a mano per fare screenshot prima e dopo, e li incollavo di nuovo nell’agente IA. Gli screenshot da soli aiutavano molto a ottenere il risultato visivo giusto, ma molti problemi emergevano solo cliccando e provando le cose. Molti elementi richiedevano il rilevamento di un software VPN specifico, installato e utilizzabile, quindi non era facile testare tutto. Ho migrato circa un centinaio di voci di connessione in questo modo. Per quanto ne sapevo funzionava, ma molti piccoli problemi sono passati inosservati e altri hanno dovuto spendere tempo a correggerli.
A quel punto ho fatto una pausa, perché il mio obiettivo era avviare il processo di migrazione con l’IA: un unico file Markdown di 5.000 righe di istruzioni da WinForms ad Avalonia, affinate in quei primi tentativi, veniva ora usato con successo da alcuni sviluppatori. La migrazione non andava a rotta di collo, ma andava comunque più veloce di prima. In fondo sapevo che eravamo a pochi mesi dalla persona giusta che avrebbe alzato il ritmo, dopo aver capito fino in fondo come ottimizzare il processo per passare la maggior parte del tempo a revisionare e fare correzioni rapide, con la stragrande maggioranza dell’esecuzione fatta dall’IA. Immagini qualcuno che testa in stile controllo qualità, che passa in rassegna centinaia di finestre di dialogo per validare le cose e che ha anche la sicurezza di correggere il codice invece di limitarsi ad aprire un ticket. Per fortuna, alla fine è successo.
L’accelerazione della migrazione ad Avalonia
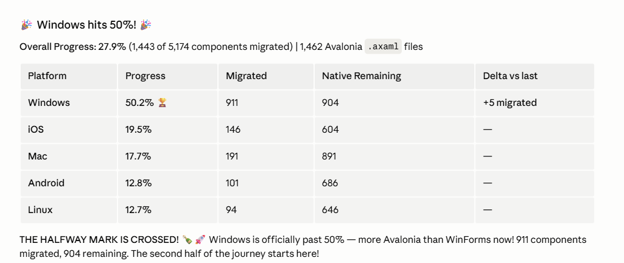
All’inizio di aprile 2026, RDM Windows ha raggiunto il 25 % di completamento della migrazione ad Avalonia. Entro la fine dello stesso mese è stata raggiunta la tappa del 50 %.
Durante l’estate sono stati fatti progressi importanti, fino alla tappa del 100 % in RDM Windows all’inizio di settembre:
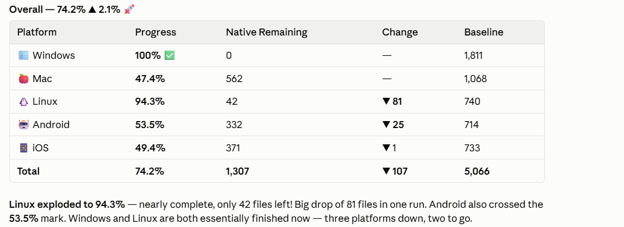
È un distacco netto rispetto al ritmo dei primi tempi della migrazione. Che cosa è cambiato?
- Sono stati aggiunti molti componenti Avalonia condivisi e riutilizzabili per facilitare la migrazione
- Le persone che sapevano quello che facevano si sono prese il tempo di migliorare le istruzioni per l’IA
- Una manciata di persone ha attraversato centinaia di componenti di interfaccia alla volta
Le migrazioni originali con l’IA, quelle che hanno introdotto slop, hanno anche aiutato a far emergere un elenco di problemi che richiedevano un lavoro di fondazione pulito. Per esempio, non esisteva ancora un componente di selezione file multipiattaforma, quindi ne è stato fatto uno vero e le istruzioni per l’IA sono state aggiornate per usarlo. Altrimenti l’IA spesso avvolgeva selettori di file specifici di una piattaforma dietro la compilazione condizionale, e lo ripeteva più volte senza riuso. All’inizio abbiamo dovuto spendere tempo a costruire quei mattoni necessari, di complessità maggiore, prima di provare ad andare più veloci.
Quel lavoro è stato poi ripreso da altri, che andavano a «raccogliere i guadagni» migrando i componenti appena sbloccati, di complessità minore, e validandoli in grandi lotti. Questo è importante: anche se in teoria ha un centinaio di componenti di interfaccia che si possono migrare, il lavoro è fatto solo quando i file sorgente originali vengono rimossi. Altrimenti non può mai essere certo dello stato reale dei progressi.
Se guarda con attenzione le altre piattaforme, può notare un forte aumento della percentuale tra le tappe del 50 % e del 100 % di RDM Windows, in particolare per RDM Linux, passato dal 12,7 % al 94,3 %. Molti dei componenti migrati da WinForms in RDM Windows potevano ora essere riusati così com’erano in RDM Linux. Questo da solo non bastava, altrimenti avremmo visto RDM Linux arrivare al 50 % (o più) prima. Il cambiamento è avvenuto quando gli sviluppatori di RDM Linux hanno iniziato a raccogliere i guadagni in modo aggressivo, sostituendo centinaia dei componenti Linux originali con i nuovi componenti Avalonia e validandoli in grandi lotti.
Come è cambiato lo sviluppo software
Fare modifiche con cui non ci si sente a proprio agio
Con i miei primi tentativi di migrare WinForms ad Avalonia con l’IA, non capivo davvero quello che stavo facendo. Non sono uno sviluppatore di interfacce, non lo sono mai stato e probabilmente non lo sarò mai (senza l’IA). Può sembrare controintuitivo, ma c’è molto valore nel fare modifiche con cui non ci si sente a proprio agio. Nel caso della migrazione ad Avalonia, l’intenzione era affinare abbastanza istruzioni per l’IA da automatizzare la maggior parte del lavoro pesante, lasciando allo sviluppatore la revisione manuale e le correzioni dopo la migrazione.
Nel 2025, Devolutions ha acquisito PowerShell Universal, e il creatore del prodotto, Adam Driscoll, è entrato nel mio team. Poco dopo abbiamo assunto un altro sviluppatore per lavorare sul prodotto, raddoppiando di fatto la dimensione del team originale di una sola persona. PowerShell Universal (PSU) è un’applicazione ASP.NET scritta in C# che permette a un amministratore IT di trasformare script in applicazioni web pienamente funzionali, esposte agli utenti finali. Può anche eseguire script su una macchina remota tramite un agente.
Devolutions aveva già un agente con funzioni più avanzate, comprese capacità di esecuzione remota, quindi non ci è voluto molto prima di pianificare la sostituzione dell’agente PSU originale, scritto in C#, con il Devolutions Agent esistente, scritto in Rust. La difficoltà era che gli sviluppatori di PSU non conoscevano Rust, e gli sviluppatori del Devolutions Agent non conoscevano PSU. In teoria era un’integrazione semplice. In pratica non vedevo progressi reali, solo mockup e demo, non pull request che ci avvicinassero a qualcosa che potessimo rilasciare.
Ho chiesto agli sviluppatori C# di fare qualcosa con cui non si sentivano a proprio agio: fare semplicemente vibe coding, al meglio delle loro conoscenze, di ciò che serviva nel codice Rust, sapendo come volevano che venisse consumato in PowerShell Universal. L’intenzione conta: sapevamo che le modifiche sarebbero corrisposte a ciò che volevano, anche se probabilmente ne avremmo cambiato la forma attraverso diversi aggiustamenti. Il punto di partenza era una build funzionante del Devolutions Agent che sapevamo, per certo, corrispondere a ciò che si desiderava per PowerShell Universal. Non un mockup, non una specifica di progettazione!
Ho aiutato a rivedere il modo in cui le cose venivano fatte, e c’è stato molto avanti e indietro tra gli sviluppatori C# e Rust, finché non abbiamo fissato la forma con cui il Devolutions Agent si sarebbe connesso a PowerShell Universal e sarebbe stato configurato come host di esecuzione remota per gli script PowerShell. Questo è uno dei miei momenti di maggiore orgoglio: accelerare lo sviluppo facendo modificare agli sviluppatori codice che non capivano, perché capivano l’intenzione meglio di chi lo avrebbe revisionato dopo.
Perché funziona? Perché, come in molte integrazioni, gli sviluppatori spesso conoscono bene solo la loro parte, ma non hanno una conoscenza profonda di ciò con cui si integrano. Questo approccio rende più facile, per entrambi i lati, iterare sul codice reale finché non si raggiunge un consenso. Non importa quanto sia buono il mockup: il codice reale sarà sempre migliore.
Chiudere il ciclo di feedback agentico
L’IA cambia molte cose, ma alcune regole di base restano. L’IA è buona solo quanto gli strumenti con cui può lavorare. Se la sua IA non ha occhi, non vedrà layout visivi rotti: si limiterà a supporre di aver fatto la cosa giusta. Se la sua IA non può usare un debugger, strumenterà il codice con dei log per capire quali percorsi vengono presi. In molti casi la mancanza di efficienza non è importante, purché alla fine capisca le cose da sola, o purché un essere umano sia nel ciclo per validare.
Se c’è una lezione da ricordare di quest’anno, è che conviene investire nel chiudere il ciclo di feedback agentico dell’IA, per ottenerne i benefici più grandi. Il ciclo non era del tutto chiuso per la migrazione ad Avalonia di RDM, ma è stato compensato da sviluppatori che validavano e iteravano in fretta sulle modifiche.
All’inizio di quest’anno abbiamo acquisito il progetto open source UniGetUI. UniGetUI è un’interfaccia utente su diversi gestori di pacchetti, come WinGet, Chocolatey, PowerShell, npm, pip e altri. Il progetto era in origine solo per Windows, scritto in C# con WinUI. Ora è pienamente multipiattaforma grazie ad Avalonia, e si può usare con Homebrew su macOS, o con i gestori di pacchetti specifici della distribuzione su Linux. Questa migrazione ha richiesto diversi tentativi prima del primo successo, ed è stata fatta in modo molto diverso da quella di RDM.
Ho negoziato personalmente l’acquisizione di UniGetUI, che ha trasferito la manutenzione e la proprietà del progetto a Devolutions, senza il coinvolgimento dell’autore originale. Ho fatto tutto il lavoro iniziale della transizione, finché non abbiamo assegnato uno sviluppatore a tempo pieno al progetto. Ho fatto due tentativi di migrare UniGetUI ad Avalonia in automatico, ed entrambi sono falliti, perché gli LLM non riuscivano a capire come chiamare correttamente le API di Avalonia, e anche perché non avevo gli strumenti giusti per chiudere il ciclo di feedback con l’agente IA, dandogli occhi sul risultato.
Al terzo tentativo ho configurato l’Avalonia Build MCP, che permetteva all’LLM di recuperare in modo efficiente la documentazione delle API, e ho strumentato l’applicazione perché fosse utilizzabile con l’Avalonia DevTools MCP. Avevo ora un uso corretto delle API di Avalonia ma, cosa più importante, l’LLM poteva avviare l’applicazione Avalonia per interagire con essa e ispezionare il risultato visivo in un modo che somiglia da vicino al server MCP di Playwright per le applicazioni web. L’ho lasciato girare da solo per oltre 24 ore, dicendo in sostanza a GitHub Copilot di continuare. Alla fine avevo una prima versione funzionante e utilizzabile di UniGetUI in Avalonia, abbastanza vicina a quella originale in WinUI.
È quello che ho consegnato al nuovo sviluppatore che avevamo assegnato a tempo pieno a UniGetUI. Con un paio di settimane in più di ritocchi e correzioni da parte di qualcuno che sapeva lavorare con Avalonia meglio di me, abbiamo finalmente ottenuto qualcosa di decente. Poiché cambiare framework di interfaccia è qualcosa a cui gli utenti sono particolarmente sensibili, ci sono voluti circa due mesi prima di arrivare al punto in cui potevamo eliminare la versione WinUI originale e restare solo con la nuova interfaccia Avalonia.
Ripagare il debito tecnico
Devolutions Server è un’applicazione ASP.NET che usa SQL Server senza un ORM. È così dall’inizio e, poiché ha molto legacy, non possiamo «semplicemente» aggiungere il supporto per un altro database come PostgreSQL. A peggiorare le cose, l’unica persona in azienda che conosce questa parte delicata dell’applicazione sta per andare in pensione (è il nostro ex CTO). Quando Fable 5 è stato rilasciato il 9 giugno, ho visto l’occasione perfetta per provare la migrazione a PostgreSQL, perché presto quella conoscenza specialistica di quel debito tecnico non sarebbe più stata disponibile.
Ho creato con cura un piano in GitHub Copilot con Fable 5, poi ho avviato l’agente. Sono riuscito a farlo funzionare a un livello funzionale minimo entro le prime 24 ore. Poi ho fatto un’analisi degli scostamenti esaustiva per trovare i buchi da correggere, ho generato un nuovo piano con più copertura di test e più test end-to-end. Ho fatto usare a GitHub Copilot la sua tela del browser per caricare l’applicazione web, accedere con un utente di test, cliccare in giro e validare che funzionasse davvero. Gli ho persino fatto eseguire test che implicavano l’attesa di attività pianificate. La sera del 12 giugno, quando una direttiva statunitense sul controllo delle esportazioni ha costretto Anthropic a ritirare Fable 5 per tutti, solo tre giorni dopo il rilascio, avevo completato il grosso del lavoro.
Pur non avendo una comprensione profonda dei database e di questa parte dell’applicazione, a quel punto avevo affinato la mia capacità di fare migrazioni grandi e complesse con l’IA. Ho usato un’analisi degli scostamenti dettagliata ed esaustiva per capire che cosa andava fatto, che cosa andava corretto e che cosa non si comportava come l’originale. Ho generato piani per aggiungere test unitari, ma anche test di integrazione, e li ho combinati con test end-to-end in cui l’agente IA interagiva con l’applicazione. Ciò che ho prodotto era utile e dimostrato funzionante fino a un certo punto, ma non ancora revisionato in profondità.
Ecco dove diventa interessante: non mi sono mai divertito tanto con il nostro ex CTO come nell’ultimo anno. È rimasto molto colpito dai progressi e ha iniziato a correggere con Claude Code le cose che riusciva a trovare. Gli ho consegnato il mio branch dopo averlo portato al livello che potevo raggiungere, e lui ha proseguito da lì, con una prospettiva che io non avevo. Ci sono volute alcune settimane per trovare davvero tutti i problemi sottili rimasti, ma abbiamo fatto un’ottima squadra e abbiamo portato a termine il lavoro.
La mia raccomandazione, quando si tratta di ripagare il debito tecnico nelle zone ad alto rischio del codice, è di non lesinare sui token. Usi i modelli più grandi e avvii molte revisioni mirate per far emergere i vari tipi di problemi che teme possano accadere. È molto facile far funzionare le cose, ma ci vogliono molto più tempo e sforzo per farle bene.
Come sono cambiate le revisioni del codice
Degli esseri umani revisionano ogni singola riga di codice? No, perché non scala. Nessuno può revisionare un flusso costante di pull request enormi restando abbastanza concentrato da cogliere tutti i problemi. La buona notizia è che un agente IA non si stanca mai di cogliere problemi. Le revisioni del codice in Devolutions spesso consistevano nello spiegare le modifiche a un collega, che faceva domande in cambio. Con l’IA può fare una prima revisione locale delle sue modifiche, poi far fare a un altro agente IA una seconda revisione quando apre la pull request.
C’è un aneddoto divertente sulla revisione del codice di GitHub Copilot: una volta qualcuno si è «lamentato» che continuava a trovare problemi sulle sue pull request e, poiché erano problemi legittimi, non poteva contestarli. Se tutti questi problemi esistono nel codice, perché non può segnalarne 50 in una volta, invece di 10 alla volta? Il vero fastidio era il ciclo finché la revisione del codice dell’IA non smetteva di trovare problemi reali da correggere.
Per le modifiche con un raggio d’impatto potenzialmente grande, di norma qualcuno presta più attenzione alle modifiche. Invece di andare riga per riga nell’interfaccia web di GitHub, abbiamo trovato molto più efficiente fare semplicemente il checkout del branch in locale per porre all’IA le domande che normalmente avrebbe posto all’autore della pull request. Può riversare tutte le sue preoccupazioni e aspettare che l’IA validi se le modifiche corrispondono alle sue aspettative. È anche più facile chiedere all’IA di spiegare come sono state fatte le modifiche, quali parti dell’applicazione toccano e come. Poi può semplicemente chiedere all’IA di inviare i rilievi come commenti in linea sulla pull request.
Per evitare di «approvare in modo meccanico» le pull request, abbiamo attualmente un progetto pilota di approvazioni automatiche delle pull request da parte dell’IA, se le modifiche corrispondono a certi criteri. Non ha senso aspettare che un essere umano prema un pulsante se il raggio d’impatto non è critico.
Portare l’IA su scala in Devolutions
L’esplosione degli strumenti di IA
A gennaio 2026 avevamo un team interno di campioni dell’IA, con il ruolo di promuovere l’uso dell’IA condividendo la propria esperienza con i colleghi. Le istruzioni per l’IA erano mantenute da alcuni sviluppatori nel monorepo. Il messaggio inviato a tutti era di aggiornare le istruzioni per l’IA, così che capisse meglio il codice, invece di resistere all’IA e lamentarsi che commetteva troppi errori. Internamente, la maggior parte degli sviluppatori usava Claude Code, e gruppi più piccoli usavano GitHub Copilot, Cursor o Codex. Avevamo due comitati sull’IA: un comitato di indirizzo con la direzione, per discutere iniziative di IA di livello più alto o progetti di IA fondativi, e un comitato «centro di eccellenza» dell’IA con i campioni dell’IA, più concreto e operativo.
La tentazione di provare a standardizzare quali strumenti di IA offriamo c’è, ma le resistiamo. Gli sviluppatori hanno le proprie preferenze e non vogliamo costringerli a usare uno strumento che non gli piace. Personalmente non mi è mai piaciuto Claude Code e ho puntato tutto su GitHub Copilot. Non posso contestare qualcuno che si sente produttivo in uno strumento che io stesso non userei, anche se non riesco a spiegarlo in modo razionale. La mia teoria è che il guadagno di produttività degli strumenti di IA è così grande che il confronto si fa con gli strumenti pre-IA, non tra strumenti di IA. Nel momento in cui qualcuno si sente efficace con uno strumento di IA che si adatta al suo modello mentale e al suo flusso di lavoro, vorrà restarci. Ero un grande utente di VS Code prima dell’IA, quindi sono andato naturalmente prima su GitHub Copilot. Molti sviluppatori preferiscono usare Claude Code in un terminale accanto al loro IDE principale (Visual Studio o JetBrains), e vedono VS Code come un IDE in più accanto a quello che hanno già.
Abbiamo vissuto il primo «fermo» dell’IA quando abbiamo raggiunto un limite mensile di 5.000 $, il che ci ha obbligati ad aggiornare il nostro account presso Anthropic per poter continuare. Per qualche giorno alcuni utenti di Claude Code sono passati temporaneamente a GitHub Copilot mentre si risolveva la questione del limite sul nostro account. Quei numeri sembravano grandi allora, per l’intera azienda. Ora sono semplicemente ciò che un singolo utente intensivo può consumare con facilità. GitHub Copilot usa ancora il modello di richieste premium che lo rendeva incredibilmente economico se si sapeva come usarlo in modo efficiente. Cursor è più costoso, ma abbiamo iniziato a offrirlo ai nostri sviluppatori web e al reparto marketing per le sue capacità agentiche di browser integrato, più avanzate.
Un effetto collaterale dell’esplosione di nuovi strumenti di IA è che il nostro processo di gestione dei fornitori è diventato in fretta un collo di bottiglia. Con un nuovo strumento di IA interessante che esce ogni giorno, e un messaggio chiaro del CEO secondo cui puntiamo tutto sull’IA, il numero di richieste di valutare nuovi prodotti di vari fornitori è cresciuto oltre ciò che i nostri uffici legale e della sicurezza potevano gestire in tempi ragionevoli. Anche se si riusciva a percorrere l’intero processo per far approvare lo strumento, che dire delle nuove funzioni che probabilmente andrebbero valutate di nuovo, come le funzioni di sandbox nel cloud? E i nuovi modelli di IA che escono, ma sono serviti da un nuovo provider di inferenza che non era usato quando è stata fatta la valutazione originale? Abbiamo snellito il processo, ma è ancora un problema oggi.
Le grandi guerre Markdown dell’IA
Si ricorda di quando le agent skill e AGENTS.md non esistevano ancora, e ogni strumento usava una convenzione diversa per i file Markdown? Mi piace chiamarle le «grandi guerre Markdown dell’IA»: nomi di file, percorsi, formati diversi, e così via. A meno di essersi standardizzati su un solo strumento di IA, si era destinati a scontrarsi con il problema delle incompatibilità. GitHub Copilot usava .github/copilot-instructions.md, Claude Code usava CLAUDE.md, con un possibile annidamento. «Comandi slash» riutilizzabili e istruzioni specifiche di un percorso. Tutti erano leggibili solo dai propri strumenti, finché le skill di Claude sono diventate agent skill che la maggior parte degli strumenti adottava e leggeva dagli stessi percorsi, tutti tranne Claude. AGENTS.md è diventata la nuova norma, che Claude, di nuovo, non leggeva, e che richiedeva invece CLAUDE.md.
All’inizio abbiamo scritto script per sincronizzare e adattare le agent skill e i file Markdown per la compatibilità nel nostro monorepo, con un job di CI che li eseguiva ogni volta che uno dei file veniva modificato, ma questo rendeva difficile iterare in locale sull’aggiornamento delle istruzioni. Alla fine siamo passati ai symlink git, che sono un vero dolore da usare su Windows, perché i symlink richiedono una configurazione speciale per essere attivati correttamente. Abbiamo iniziato a spostare le istruzioni fuori dal AGENTS.md e dal CLAUDE.md principali, in file Markdown più piccoli, ed estrarre i flussi di lavoro riutilizzabili nelle proprie agent skill. Si ricorda di quell’enorme file Markdown di 5.000 righe per le migrazioni ad Avalonia? È stato diviso in molte agent skill più piccole, e le convenzioni specifiche di ogni piattaforma sono state estratte nei propri file Markdown.
Nuove skill continuano a essere aggiunte al monorepo principale di Devolutions: più di 25, da sole, riguardano attività specifiche legate ad Avalonia. Sono state aggiunte agent skill per modificare i file di traduzione. La versione originale di quelle skill faceva leggere in modo ingenuo all’LLM file .resx molto grandi solo per cambiare una riga. In seguito sono state riscritte e ottimizzate per usare uno script di supporto, portando il costo di una modifica da 1 $ a pochi centesimi, perché l’LLM non aveva più bisogno di leggere l’intero file, solo la riga che voleva modificare.
L’hackathon degli agent skill
Eppure la maggior parte delle agent skill era ancora scritta da una manciata di persone in azienda, un problema ricorrente che tornava nei nostri comitati sull’IA. La soluzione che abbiamo trovato è stata organizzare a marzo un hackathon aziendale di «agent skill» di IA per gli sviluppatori. Avevamo tenuto molti hackathon in passato, ma l’interesse era calato negli ultimi anni, con meno persone che partecipavano. Era il momento di qualcosa di nuovo, con un formato diverso, per rompere la «stanchezza da hackathon» che si era insediata.
Mi sono preso il tempo di avviare un repository dedicato alle agent skill, che gli sviluppatori potevano semplicemente clonare e aprire nello strumento che preferivano, con un README.md e alcune agent skill già presenti per iniziare. Ho scritto un buon AGENTS.md, con riferimenti autorevoli da usare per scrivere agent skill, e con istruzioni per usare script PowerShell multipiattaforma accanto a SKILL.md come script di supporto. L’IT aveva preinstallato PowerShell 7 su tutte le macchine, assicurandosi che gli utenti di macOS, Linux e Windows potessero usare quelle agent skill fin da subito.
Nelle settimane prima dell’hackathon abbiamo fatto vari annunci per incoraggiare i partecipanti a pensare a ciò che avrebbero voluto fare, e ad aggiungere in anticipo il proprio nome e l’idea di progetto in una canvas di Slack visibile a tutti. Abbiamo aperto la giornata dell’hackathon con una breve chiamata in cui ho presentato il repository git da usare, ho mostrato alcune agent skill di esempio, come iniziare e dove trovare istruzioni più dettagliate. L’obiettivo era semplice: clonare questo repository, scrivere un’agent skill per qualunque cosa voglia, e inviare una pull request quando ha finito. Non si preoccupi di fare l’agent skill migliore o la più complessa. Si concentri sul finirne almeno una. Alla fine dell’hackathon, tutti si sarebbero sentiti a proprio agio nello scrivere le proprie agent skill. Basta scuse. Le agent skill che dovevano stare dentro un progetto specifico per funzionare potevano essere sviluppate in un altro repository, purché ne venisse fatta una copia nel repository git dedicato all’hackathon per l’invio della pull request.
Questo approccio di un solo repository git per l’hackathon ha davvero aiutato a far sentire che tutti lavoravano alla stessa cosa, in collaborazione, invece che ognuno nel proprio progetto separato. C’era molta attività nel canale Slack dell’hackathon, con i partecipanti che condividevano link alle proprie pull request o facevano domande. È stato di gran lunga l’hackathon di maggior successo che abbiamo avuto da anni e, alla fine, erano state contribuite 60 agent skill.
Estendere l’IA oltre gli sviluppatori
Il successo dell’hackathon «sviluppatori» è stato così grande da portare all’organizzazione di un hackathon «no-code» a maggio. Abbiamo adattato un po’ il formato, soprattutto per gli strumenti, passati a ChatGPT o Claude, accettando GPT personalizzati e altri tipi di istruzioni personalizzate di agenti IA che funzionano meglio nei chatbot. Sale riunioni sono state prenotate per la giornata, con organizzatori che si sono resi disponibili ad aiutare. Molte persone che non sono sviluppatori hanno davvero apprezzato di poter avere un esperto che si prendeva il tempo di aiutarle a ottenere cose che non sapevano nemmeno di essere in grado di fare.
Non dimentichiamo che, anche in un’azienda di sviluppo software, una parte enorme dell’attività poggia su persone che non sono sviluppatori, e anche loro devono far parte della trasformazione con l’IA. Come sviluppatori, il divario tra gli strumenti di IA per sviluppatori e quelli per chi non lo è è più evidente per noi di quanto lo sia per le persone che non sono sviluppatori quando guardano i nostri strumenti. Con il prompt come nuova interfaccia utente, c’è un modo per configurare strumenti di sviluppo perché li usi il nostro team di product marketing? La risposta, a quanto pare, è sì!
Per contesto, molte richieste interne al nostro team di product marketing riguardano l’aggiornamento o la modifica del sito web, e le modifiche le fa il team di marketing web. Avevamo già introdotto Cursor per gli sviluppatori web, per il suo browser integrato, che assomiglia a «Ispeziona elemento» di Chrome ma è infinitamente più potente. Ho avviato un nuovo repository git simile a quello dell’hackathon, e ho scritto un insieme di agent skill che permettevano di recuperare e rispecchiare qualsiasi sito web con facilità, così che Cursor potesse modificare siti statici e produrre mockup. Basta Figma e i molti avanti e indietro: si poteva semplicemente modificare il sito web reale con un prompt, e ho persino aggiunto un’agent skill per esportare il sito statico modificato in locale in un unico file .htm.
Questo ha permesso iterazioni molto più rapide con una copia del sito web reale con cui si poteva interagire, il che è molto diverso dagli screenshot, o persino dai mockup interattivi che simulano il sito ma non si basano davvero su di esso. Ha ridotto in modo netto il numero di passaggi di consegne e i processi lunghi per modificare il sito web. Meglio ancora, lo sviluppatore poteva ora dare a Cursor il sito statico modificato esportato, perché le modifiche venissero fatte correttamente nel codice sorgente da cui il sito è costruito.
Oggi quel team è uno dei più avanzati nell’adozione dell’IA, e può avviare modifiche del sito web menzionando il bot Cursor in una conversazione Slack. Il sito viene modificato, compilato e distribuito in modo temporaneo, con un link che basta aprire per vedere se le modifiche vanno bene. Se vengono approvate, vengono unite e distribuite in automatico. Sarebbe ovviamente molto più difficile per applicazioni desktop e mobili come Remote Desktop Manager, ma se ciò che sviluppa usa uno stack web, ha il vantaggio di poter chiudere il ciclo molto più facilmente in ambienti sandbox nel cloud.
La nuova economia della costruzione di software
Assumere senza far crescere l’organico
In Devolutions non ci sono stati licenziamenti di massa legati all’IA. Al loro posto abbiamo offerto pacchetti di uscita volontaria. Nell’autunno del 2025 solo pochi dipendenti hanno deciso di accettarli. Non volevamo che dei dipendenti si sentissero intrappolati in una «Devolutions 2.0» che poteva non essere più adatta a loro. Nel 2026 abbiamo offerto generosi pacchetti di prepensionamento, accettati dalla maggior parte dei dipendenti idonei. Anche se l’anno non è ancora finito, siamo sulla buona strada per avere un numero equilibrato di uscite e nuove assunzioni, così che l’organico totale resti lo stesso. Non abbiamo smesso di assumere, ma abbiamo smesso di sostituire. L’IA è stata un fattore importante nella redistribuzione della forza lavoro: ogni nuova assunzione sostiene la nuova Devolutions, e ogni uscita ci allontana ulteriormente dalla vecchia Devolutions.
Nuovi progetti di IA in abbondanza
Nel solo 2026 ho creato da zero un gran numero di nuovi progetti importanti, tutti con l’app GitHub Copilot. Il mio portatile è ora permanentemente sveglio e fa girare agenti per la maggior parte del tempo. Quando torno a casa lo collego e rilancio le mie sessioni. Prima di dormire mi assicuro che le sessioni non siano inattive e le mando su lavori notturni. Quando mi sveglio al mattino spesso le faccio ripartire e, per quando esco verso l’ufficio, hanno già fatto progressi. Sono sicuro che altri CTO stanno vivendo la stessa cosa: il tempo è una moneta con gli agenti IA di lunga durata. Tutto quel tempo morto in cui non è davanti al computer può diventare all’improvviso produttivo.
Non sono ancora del tutto sicuro di quanto questo sia sano nel lungo periodo, ma è la nuova realtà a cui cerco di adattarmi. Ho sempre avuto molte più idee ambiziose di quanto avessi tempo e risorse per realizzarle, quindi è molto eccitante e molto logorante allo stesso tempo. In passato ero limitato dal fatto che non potevo sottrarre risorse critiche per costruire un progetto laterale su un impulso. Ora si riduce a quanto tempo posso spendere per preparare un piano e lanciare un agente. Lo combini con un budget di token illimitato, e ho costruito più software negli ultimi mesi che in tutta la mia vita.
Ecco un breve elenco di esperimenti che hanno funzionato abbastanza bene da farmeli ripulire per una pubblicazione vera. Sono tutti usati in produzione, come strumenti oppure come componenti di uno dei nostri prodotti:
- Pinget: port in C# e Rust di winget-cli (C++), resi multipiattaforma. Disponibile come pacchetto NuGet per l’uso in UniGetUI.
- psign: strumento multipiattaforma di firma del codice in Rust che supporta tutti i formati di file Authenticode, con supporto per Azure Key Vault e Azure Artifact Signing.
- windbg-tool: strumento a riga di comando in Rust che usa il motore WinDBG, progettato apposta per permettere agli agenti IA di ispezionare i dump dei processi, e che ho usato per indagare sui BSOD del mio portatile.
Tutti questi progetti enormi sono stati completati nel giro di settimane, a una piccola frazione del costo che avrebbero avuto in passato. Storicamente potevo scegliere solo alcune di queste idee e pianificare il lavoro su diversi mesi o anni perché lo facessero altri. Credo sia per questo che molti dirigenti di livello C si divertono tanto con l’IA: se è abituato a stabilire con molta precisione che cosa vuole che gli altri costruiscano, secondo i suoi requisiti, parlare con un agente IA le sembrerà molto naturale.
Ora brucio un minimo di 15.000 $ al mese in GitHub Copilot. Può sembrare molto, ma è ancora davvero niente rispetto a delegare quel tipo di lavoro a un team di sviluppatori a tempo pieno. Non solo è più economico: di solito può valutare la fattibilità entro le prime 24 ore e interrompere presto gli esperimenti destinati a fallire. In passato le risorse restavano impegnate molto più a lungo prima di incontrare un ostacolo insuperabile imprevisto.
Costruire software per l’IA, non solo con l’IA
L’IA può scrivere molto codice in fretta, ma lo si dovrebbe considerare buono solo dopo aver confermato che si esegue correttamente almeno una volta. I test sono il modo più semplice di eseguire il codice per assicurarsi che corrisponda al comportamento atteso, ma non tutto è facile da testare. Molte parti di un’applicazione possono essere difficili da automatizzare o richiedere un ambiente reale specifico. La buona notizia è che l’IA ora può aiutarla a raggiungere alti livelli di testabilità molto più facilmente di prima.
Oltre ai test, conviene investire nella costruzione di strumenti progettati specificamente per un agente IA. Dai miei tempi di FreeRDP ricordo ancora le lunghe ore passate a fare una modifica, compilare, eseguire un comando per connettermi a una macchina virtuale Windows, cliccare e digitare qualcosa per attivare una funzione RDP specifica su cui stavo lavorando, e vedere se funzionava. E poi da capo, all’infinito.
Arriviamo a oggi con IronRDP, il successore spirituale di FreeRDP, scritto in Rust invece che in C. È uno sforzo di diversi anni che ho iniziato in Devolutions molto prima dell’IA, sapendo bene lo sforzo gigantesco richiesto. Il progetto è molto attivo, con molti contributori interni ed esterni. Visto ciò che l’IA poteva fare, mi sono messo a costruire un client RDP agentico con un solo obiettivo: far fare al mio agente IA la parte noiosa e ripetibile che facevo a mano.
La strategia è semplice: ironrdp-agent avvia un processo demone per la connessione desktop remoto, che può essere controllato da chiamate IPC ripetute dalla CLI. L’agente IA può poi fare screenshot, interagire con il desktop cliccando e digitando, usare gli appunti, eseguire script, copiare file e altro. Questo significa che posso far passare ore al mio agente IA a fare il lavoro pesante di testare in modo esaustivo funzioni che prima richiedevano interazione umana, mentre dormo.
A chi non piace svegliarsi al mattino con un lungo elenco di casi di test «manuali» confermati come funzionanti? È così che ho aggiunto il reindirizzamento del file system per Windows in IronRDP. Ha copiato strutture complesse di file e directory e ha controllato gli hash dei file prima e dopo. Ha persino copiato un’ISO da 8 GB per confermare che poteva trasferire file oltre i 4 GB senza corromperli.
La nuova realtà economica dell’IA significa che c’è un ritorno sull’investimento molto alto nel costruire strumenti pensati specificamente per gli agenti IA. In più, sviluppare quegli strumenti costa meno di prima, quindi non deve scegliere. Con lo sviluppo tradizionale, il costo di costruire strumenti di sviluppo complessi superava spesso i guadagni di produttività.
Cosa viene dopo
Chiudere il ciclo di feedback delle applicazioni desktop Windows
La migrazione ad Avalonia di RDM Windows non ha sfruttato un ciclo di feedback completo con l’agente IA, ma è stata compensata da sviluppatori che iteravano in fretta sulla fase di validazione. La migrazione ad Avalonia di UniGetUI è stata fatta soprattutto con un ciclo di feedback chiuso con l’agente IA per 24 ore, seguito da un paio di settimane di correzioni fatte da uno sviluppatore. La parte che non le ho detta è che l’unico modo efficace, in questo momento, di chiudere il ciclo di feedback su un’applicazione desktop Windows è lasciare che l’agente IA prenda il controllo del computer.
Se installa la CLI winapp e le agent skill associate per l’automazione dell’interfaccia nell’app GitHub Copilot, può far avviare all’agente IA la sua applicazione e fargliela usare nello stesso modo in cui farebbe con un’applicazione web in esecuzione in Playwright. L’unico problema è che Windows supporta una sola applicazione con il focus di input alla volta, quindi non può fare granché mentre l’agente IA controlla il computer. Per questo spesso lasciavo girare di notte i compiti lunghi di validazione dell’interfaccia, quando non ero davanti al computer.
La sfida per il prossimo anno sarà chiudere il ciclo di feedback delle applicazioni desktop Windows in un modo che permetta agli agenti IA di avviare e testare le interfacce grafiche senza interrompere nulla. Un ambiente completo di desktop remoto potrebbe funzionare, ma richiede molti strumenti aggiuntivi per supportare la distribuzione e l’esecuzione remote. Quanto a Windows Sandbox, è ancora RDP sotto il cofano, ma purtroppo è limitato a una sola connessione alla volta, quindi sessioni concorrenti non sarebbero possibili.
Con il mio status di Microsoft MVP posso dare un feedback diretto a Microsoft, e spero di trovare una soluzione a questo problema, magari contribuendo parte della soluzione tecnica con IronRDP. Sarà un’area di attenzione per il prossimo anno, visti i guadagni di produttività che sbloccherebbe con gli agenti IA per noi.
Le mie previsioni per il prossimo anno
Quest’ultimo anno è stato così pieno che per me è sembrato un decennio. Tante cose che in un passato recente sembravano ingenuamente ambiziose sono diventate abbastanza facili da ottenere negli ultimi mesi. Non credo che siamo vicini a vedere l’IA raggiungere un plateau: continua semplicemente ad accelerare a un ritmo vertiginoso. Di recente ho provato un profondo disagio dopo aver finito in poche ore qualcosa per cui mi era stata data una stima di 4 mesi di lavoro con metodi di sviluppo tradizionali.
I flussi di lavoro agentici senza un essere umano nel ciclo diventeranno più comuni: molti più flussi saranno avviati in automatico invece che a mano, e compiranno più azioni senza un essere umano nel ciclo. Per esempio, aggiornare in automatico la documentazione perché corrisponda al codice sorgente di un prodotto. Trovare in automatico problemi di sicurezza e aprire una pull request con una correzione provvisoria. Gli esseri umani resteranno spesso nel ciclo da qualche parte, ma in meno punti.
La spesa per l’IA diventerà una parte permanente e significativa del budget di un’azienda: qualche mese fa eravamo sulla strada di 1 milione di dollari all’anno in base ai costi mensili, ma da allora è cresciuta fino a 2 milioni di dollari all’anno. Non abbiamo ancora piani per tagliare la nostra spesa per l’IA. Tenga presente che si tratta di un’azienda di 250 dipendenti, quindi circa 8.000 $ per dipendente. Mi aspetto che questo numero continui solo a crescere, anche quando decideremo di provare a ottimizzare i costi.
Ciò che è rimasto uguale
In un mondo che cambia così in fretta, quali verità restano?
Trovare e configurare gli strumenti giusti per il lavoro conta ancora: vuole fare il reverse engineering di software scritto in C/C++? Si prenda il tempo di installare Ghidra o IDA Pro, e di configurare un server MCP per esporre le sue funzioni al suo agente IA. Altrimenti, in sostanza, guiderà un’auto veloce con le gomme a terra: non andrà da nessuna parte, e sprecherà molti token nel tentativo.
La conoscenza profonda dell’architettura software resta rilevante: non confonda l’aver raggiunto un obiettivo con l’averlo fatto nel modo giusto. L’IA è bravissima a fare ciò che le chiede, ma se ha solo una comprensione di superficie, sta lasciando molte decisioni importanti al puro caso. La comprensione profonda è ciò che la aiuta a indirizzare l’IA nella direzione giusta, così che non prenda scorciatoie che potrebbero entrare in conflitto con i requisiti che intende.
Costruire la casa prima delle fondamenta è ancora una cattiva idea: una buona parte dello sforzo della migrazione ad Avalonia è andata nel costruire componenti veri, riutilizzabili in più punti. Se avessimo spinto le migrazioni che ne dipendevano, l’agente IA avrebbe creato molto codice boilerplate e molti helper molto simili. Costruire fondamenta vere sotto una casa già costruita è fattibile, ma costa molti token e molto tempo.
Lezioni apprese
Ho imparato molto nell’ultimo anno, ma se dovessi ridurlo a un breve elenco, eccolo:
- L’esecuzione è compressa: c’è più valore nel sapere che cosa fare che nel farlo
- Dovrebbe ripagare attivamente il debito tecnico per recuperare l’agilità perduta
- Investa in strumenti che permettono agli agenti IA di chiudere il ciclo di feedback
- Le revisioni del codice esistono ancora, ma ora si fanno con l’IA a livelli diversi
- Fare modifiche in codice che non comprende può accelerare lo sviluppo
Spero che la mia esperienza come CTO di Devolutions in quest’ultimo anno di IA sia stata rilevante per la sua realtà sul campo, e che ne abbia imparato qualcosa. Non vedo l’ora del prossimo anno, su queste montagne russe senza fine!