











 Marc-André Moreau
Note : ce billet long a d’abord été écrit pour le défi d’essai de The Pragmatic Engineer sur l’évolution du génie logiciel.
Octobre 2025. Claude Sonnet 4.5 vient de sortir, et tout le monde chez Devolutions suit une formation en IA donnée par Mindstone. Le message du PDG est clair : nous prenons toutes les mesures nécessaires pour faire de l’entreprise une organisation native de l’IA. Les employés qui ne veulent pas prendre part à cette nouvelle « Devolutions 2.0 » se voient offrir une indemnité de départ volontaire. Ceux qui restent doivent s’engager et passer à fond à l’IA avec le reste d’entre nous. Voici l’histoire du profond virage qui s’est produit chez Devolutions, et comment une migration majeure, estimée au départ à trois ans, a été terminée en un an seulement.
Devolutions est une entreprise de logiciels canadienne autofinancée, dont le bureau principal est à Lavaltrie, au Québec, et qui compte plus de 250 employés partout dans le monde. Le nom « Devolutions » vient de « Development Evolutions », à l’époque où le fondateur, David Hervieux, réalisait des contrats de développement logiciel, bien avant le succès commercial actuel de notre produit phare, Remote Desktop Manager (RDM). RDM est un gestionnaire de connexions : il lance des connexions avec injection d’identifiants pour des protocoles comme RDP, SSH, VNC, ARD, PowerShell, etc. S’il accepte des identifiants et se connecte à quelque chose, RDM le prend déjà en charge, très probablement.
Mon équipe est un peu particulière : elle comprend les développeurs du bureau d’Ottawa, mais aussi des développeurs aux États-Unis, en Allemagne et au Japon. Nous l’appelons l’équipe « architecture » à l’interne, parce que nous sommes responsables de construire beaucoup de composants réutilisables dont les autres équipes se servent. La structure est très souple, mais chacun est très autonome, motivé et responsable. La plupart des équipes chez Devolutions travaillent en présentiel, pas à distance, au bureau principal de Lavaltrie.
Quant à moi, je suis le CTO de Devolutions. Dans une vie antérieure, j’ai fondé le projet FreeRDP. Je suis Microsoft MVP dans les catégories Windows et PowerShell. Mon domaine d’expertise principal, ce sont les protocoles Windows, surtout pour RDP et l’authentification. J’ai le chic pour la rétro-ingénierie et pour creuser dans les entrailles des systèmes. J’aime expérimenter avec la technologie afin de trouver comment assembler les pièces du casse-tête pour construire les produits que nous voulons.
Les applications de bureau Windows sont souvent laissées pour compte dans le monde de l’IA : les outils les plus populaires sont d’abord sortis sans prise en charge de Windows, et quand elle est enfin arrivée, elle était partielle. Les applications de bureau, contrairement aux applications web, sont nettement désavantagées, parce qu’elles sont beaucoup plus difficiles à valider automatiquement avec l’IA. Malgré ces défis, nous avons réussi à porter Remote Desktop Manager, une application .NET d’entreprise massive avec des milliers de boîtes de dialogue, vers Avalonia, un framework d’interface multiplateforme, en moins d’un an. Plus surprenant encore, la migration Windows a atteint 100 % en premier, devant les autres plateformes qui avaient moins de dette technique.
Compresser trois ans en un
Le grand projet de migration vers Avalonia
Nous sommes d’abord une entreprise de bureau, et nous tenons à faire de très bonnes applications de bureau. C’est pourquoi nous commanditons Avalonia à hauteur de 3 millions de dollars sur 3 ans. La raison est simple : nous ne voulons pas sacrifier l’expérience de l’application de bureau en utilisant une application web déguisée, à la manière d’Electron, mais nous devons quand même alléger le fardeau du développement en migrant vers un framework d’interface multiplateforme en .NET. Nous avons accumulé beaucoup de fonctions héritées et avancées au fil des ans, alors nous ne pouvons pas nous permettre de tout réécrire dans un nouveau framework d’interface entre deux versions majeures. Avant l’IA, nous estimions l’effort à au moins 3 ans. Avalonia nous a donné le moyen de faire une migration partielle, de façon à mélanger des éléments d’interface natifs avec Avalonia.
C’est la migration la plus ambitieuse jamais tentée chez Devolutions : plus de 1 500 éléments d’interface WinForms qui remontent à plus d’une décennie de travail, pour RDM Windows seulement. Les autres plateformes ont beaucoup moins d’éléments d’interface natifs. En octobre 2025, je cherchais comment l’IA pourrait accélérer tout cela, parce qu’à ce moment-là la migration était encore surtout manuelle. La première chose que j’ai faite a été de créer un script qui parcourait les fichiers sources de notre monorepo pour compter les éléments d’interface propres à chaque plateforme encore à migrer, à partir du tout premier commit où Avalonia a été introduit. Ce nombre est devenu notre référence, et chaque plateforme devait le ramener à zéro en retirant ces éléments au fur et à mesure de leur remplacement par Avalonia.
Le total, toutes plateformes confondues, dépassait 5 800 éléments d’interface à porter, et à ce stade la progression n’était que de quelques pour cent pour chaque plateforme.
La phase du canon à slop d’IA
Les premières tentatives pour accélérer la migration Avalonia ont produit beaucoup de slop d’IA, dont j’étais personnellement responsable pour la majeure partie. Heureusement, la frustration n’a été que temporaire et, avec le recul, c’était une étape nécessaire pour apprendre. La vraie valeur de la phase du canon à slop d’IA a été de servir d’électrochoc aux développeurs qui savaient ce qu’ils faisaient : ils ont commencé à ajouter et à améliorer les instructions destinées à l’IA pour qu’elle fasse moins d’erreurs.
Voici les défis :
- Je faisais peu d’interface moi-même, alors je ne savais pas vraiment ce que je faisais
- Les modèles d’IA d’il y a un an faisaient beaucoup d’erreurs
- L’IA n’avait pas les bons outils pour voir l’avant et l’après
RDM prend en charge beaucoup d’entrées de connexion, surtout des VPN que les utilisateurs peuvent utiliser comme dépendance d’une autre entrée de connexion. Par exemple, on peut avoir une connexion RDP qui lance automatiquement un VPN WireGuard si c’est nécessaire pour joindre le serveur RDP associé. J’ai décidé d’essayer de porter d’abord l’entrée de connexion VPN, dans l’espoir d’en extraire assez d’instructions pour que l’IA devienne bonne à porter toutes les autres entrées VPN. Il a fallu quelques tentatives, et j’ai dû demander à des collègues de m’aider à corriger des choses sur une branche expérimentale, après quoi j’ai mis à jour les instructions en pointant le LLM vers les commits pour qu’il en tire des leçons. Après quelques itérations de ce genre, les instructions étaient assez bonnes pour que je puisse porter automatiquement quelques autres types d’entrées VPN, mais elles exigeaient encore beaucoup de corrections.
Le processus est devenu semi-manuel : je lançais une session dans laquelle j’indiquais à l’agent d’analyser et de lister les prochains types d’entrées VPN les plus simples que je pouvais porter. J’en faisais des lots de 10, puis je lançais RDM manuellement pour prendre des captures d’écran avant et après, et je les recollais dans l’agent d’IA. Les captures à elles seules aidaient beaucoup à obtenir le bon rendu visuel, mais beaucoup de problèmes ne se révélaient qu’en cliquant et en essayant les choses. Beaucoup d’éléments exigeaient la détection d’un logiciel VPN précis, installé et utilisable, alors il n’était pas facile de tout tester. J’ai migré une centaine d’entrées de connexion de cette façon. À ma connaissance, cela fonctionnait, mais beaucoup de petits problèmes sont passés entre les mailles du filet, et d’autres ont dû passer du temps à les corriger.
J’ai fait une pause à ce moment-là, puisque mon but était d’amorcer le processus de migration par l’IA : un seul fichier Markdown de 5 000 lignes d’instructions WinForms vers Avalonia, affiné au fil de ces premières tentatives, était maintenant utilisé avec succès par quelques développeurs. La migration n’allait pas à un rythme effréné, mais elle allait quand même plus vite qu’avant. Au fond, je savais que nous n’étions qu’à quelques mois de la bonne personne qui accélérerait le rythme, après avoir bien compris comment optimiser le processus pour passer le plus clair du temps à réviser et à faire des corrections rapides, la grande majorité de l’exécution étant faite par l’IA. Imaginez quelqu’un qui teste dans un style d’assurance qualité, qui passe en revue des centaines de boîtes de dialogue pour valider les choses, et qui a aussi la confiance nécessaire pour corriger le code au lieu de simplement ouvrir un billet. Heureusement, cela a fini par arriver !
L’accélération de la migration Avalonia
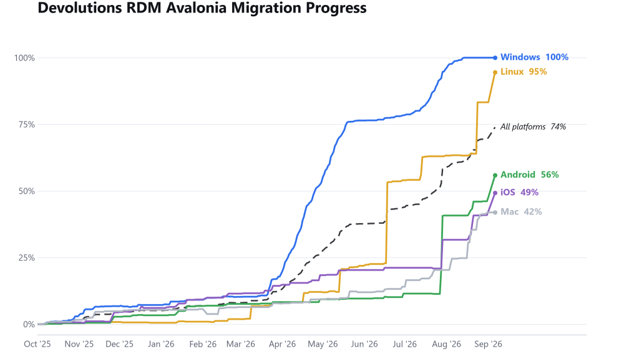
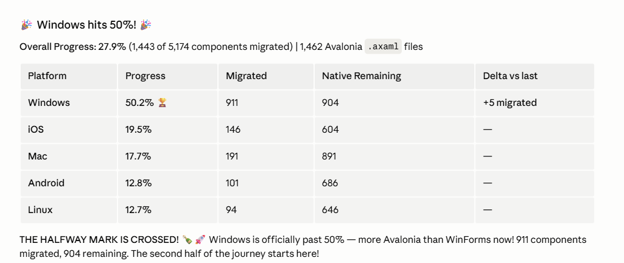
Au début d’avril 2026, RDM Windows a atteint 25 % d’achèvement pour la migration Avalonia. À la fin du même mois, le jalon de 50 % était franchi.
Des progrès importants ont été faits pendant l’été, jusqu’au jalon de 100 % dans RDM Windows au début de septembre :
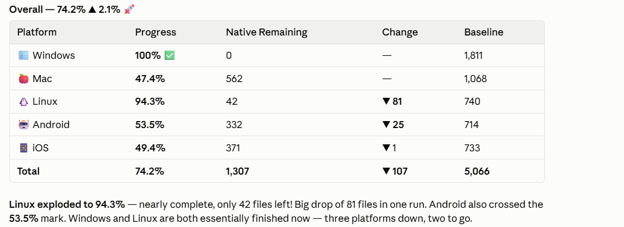
C’est un écart majeur par rapport au rythme des débuts de la migration. Qu’est-ce qui a changé ?
- Beaucoup de composants Avalonia partagés et réutilisables ont été ajoutés pour faciliter la migration
- Les gens qui savaient ce qu’ils faisaient ont pris le temps d’améliorer les instructions destinées à l’IA
- Une poignée de personnes ont traité des centaines de composants d’interface à la fois
Les premières migrations par l’IA, celles qui ont introduit du slop, ont aussi aidé à faire émerger une liste de problèmes qui demandaient un travail de fondation propre. Par exemple, il n’existait pas encore de sélecteur de fichiers multiplateforme, alors un vrai composant a été fait, et les instructions destinées à l’IA ont été mises à jour pour l’utiliser. Sinon, l’IA enveloppait souvent des sélecteurs de fichiers propres à une plateforme derrière de la compilation conditionnelle, et répétait cela plusieurs fois sans réutilisation. Nous avons d’abord dû passer du temps à construire ces briques requises, plus complexes, avant d’essayer d’aller plus vite.
Ce travail a ensuite été repris par d’autres, qui allaient « récolter les gains » en migrant les composants nouvellement débloqués, de moindre complexité, et en les validant par grands lots. C’est important : même si, en théorie, vous avez une centaine de composants d’interface qui peuvent être migrés, le travail n’est fait que lorsque les fichiers sources d’origine sont retirés. Sinon, vous ne pouvez jamais être certain de l’état réel de la progression.
Si vous regardez de près les autres plateformes, vous remarquerez peut-être une forte hausse du pourcentage entre les jalons de 50 % et de 100 % de RDM Windows, en particulier pour RDM Linux, qui est passé de 12,7 % à 94,3 %. Une grande partie des composants migrés depuis WinForms dans RDM Windows pouvait maintenant être réutilisée telle quelle dans RDM Linux. Cela seul ne suffisait pas, sinon nous aurions vu RDM Linux atteindre 50 % (ou plus) plus tôt. Le virage s’est produit quand les développeurs de RDM Linux ont commencé à récolter les gains de façon agressive, en remplaçant des centaines de composants Linux d’origine par les nouveaux composants Avalonia et en les validant par grands lots.
Comment le développement logiciel a changé
Faire des changements qui vous mettent mal à l’aise
Avec mes premières tentatives de migration de WinForms vers Avalonia avec l’IA, je ne comprenais pas vraiment ce que je faisais. Je ne suis pas développeur d’interfaces, je ne l’ai jamais été, et je ne le serai probablement jamais (sans l’IA). Cela peut sembler contre-intuitif, mais il y a beaucoup de valeur à faire des changements qui vous mettent mal à l’aise. Dans le cas de la migration Avalonia, l’intention était d’affiner assez d’instructions destinées à l’IA pour automatiser la majeure partie du travail ingrat, en laissant au développeur la révision manuelle et les corrections après la migration.
En 2025, Devolutions a acquis PowerShell Universal, et le créateur du produit, Adam Driscoll, a rejoint mon équipe. Peu après, nous avons embauché un autre développeur pour travailler sur le produit, ce qui a en pratique doublé la taille de l’équipe d’origine, qui ne comptait qu’une personne. PowerShell Universal (PSU) est une application ASP.NET écrite en C# qui permet à un administrateur TI de transformer des scripts en applications web pleinement fonctionnelles, exposées aux utilisateurs finaux. Elle peut aussi exécuter des scripts sur une machine distante à l’aide d’un agent.
Devolutions avait déjà un agent avec des fonctions plus avancées, dont des capacités d’exécution à distance, alors il n’a pas fallu longtemps avant que nous prévoyions de remplacer l’agent PSU d’origine, écrit en C#, par le Devolutions Agent existant, écrit en Rust. Le défi, c’est que les développeurs de PSU ne connaissaient pas Rust, et que les développeurs du Devolutions Agent ne connaissaient pas PSU. En théorie, c’était une intégration simple. En pratique, je ne voyais pas de vrai progrès, seulement des maquettes et des démos, pas de pull requests qui nous rapprocheraient de quelque chose que nous pourrions livrer.
J’ai demandé aux développeurs C# de faire quelque chose qui les mettait mal à l’aise : faites simplement du vibe coding, du mieux que vous le pouvez, pour produire dans le code Rust ce dont vous avez besoin, en sachant comment vous voulez que ce soit consommé dans PowerShell Universal. L’intention compte : nous savions que les changements correspondraient à ce qu’ils voulaient, même si nous allions probablement en modifier la forme au fil de plusieurs ajustements. Le point de départ était une compilation fonctionnelle du Devolutions Agent dont nous savions avec certitude qu’elle correspondait à ce qui était souhaité pour PowerShell Universal. Pas une maquette, pas une spécification de conception !
J’ai aidé à réviser la façon dont les choses étaient faites, et il y a eu beaucoup d’allers-retours entre les développeurs C# et Rust, jusqu’à ce que nous figions la forme selon laquelle le Devolutions Agent se connecterait à PowerShell Universal et serait configuré comme hôte d’exécution distante pour les scripts PowerShell. C’est l’un de mes moments de plus grande fierté : accélérer le développement en faisant modifier, par des développeurs, du code qu’ils ne comprenaient pas, parce qu’ils comprenaient l’intention mieux que ceux qui réviseraient ensuite.
Pourquoi est-ce que cela fonctionne ? Parce que, comme dans beaucoup d’intégrations, les développeurs ne connaissent souvent bien que leur partie, sans avoir une connaissance approfondie de ce à quoi ils s’intègrent. Cette approche facilite, des deux côtés, l’itération sur le vrai code jusqu’à ce qu’un consensus soit atteint. Peu importe la qualité de votre maquette, le vrai code sera toujours meilleur.
Fermer la boucle de rétroaction agentique
L’IA change beaucoup de choses, mais certaines règles de base demeurent. L’IA n’est bonne qu’à la hauteur des outils avec lesquels elle peut travailler. Si votre IA n’a pas d’yeux, elle ne verra pas les mises en page visuelles brisées : elle se contentera de supposer qu’elle a fait la bonne chose. Si votre IA ne peut pas utiliser un débogueur, elle instrumentera le code avec de la journalisation pour comprendre quels chemins sont empruntés. Dans bien des cas, le manque d’efficacité n’est pas important, tant qu’elle finit par comprendre les choses par elle-même, ou qu’un humain est dans la boucle pour valider.
S’il y a une leçon à retenir de cette année, c’est que vous devriez investir pour fermer la boucle de rétroaction agentique de l’IA, afin d’en tirer les plus grands bénéfices. La boucle n’était pas entièrement fermée pour la migration Avalonia de RDM, mais cela a été compensé par des développeurs qui validaient et itéraient rapidement sur les changements.
Plus tôt cette année, nous avons acquis le projet source libre UniGetUI. UniGetUI est une interface d’utilisateur pour plusieurs gestionnaires de paquets, comme WinGet, Chocolatey, PowerShell, npm, pip, etc. Le projet n’était à l’origine que pour Windows, écrit en C# avec WinUI. Il est maintenant pleinement multiplateforme grâce à Avalonia, et vous pouvez l’utiliser avec Homebrew sur macOS, ou avec les gestionnaires de paquets propres à une distribution sur Linux. Cette migration a exigé plusieurs tentatives avant un premier succès, et elle a été faite très différemment de celle de RDM.
J’ai personnellement négocié l’acquisition d’UniGetUI, qui a transféré la maintenance et la propriété du projet à Devolutions, sans la participation de l’auteur original. J’ai fait tout le travail initial de transition, jusqu’à ce que nous assignions un développeur à temps plein au projet. J’ai fait deux tentatives de migration automatique d’UniGetUI vers Avalonia, et les deux ont échoué, parce que les LLM n’arrivaient pas à comprendre comment appeler correctement les API Avalonia, et aussi parce que je n’avais pas les bons outils pour fermer la boucle de rétroaction avec l’agent d’IA en lui donnant des yeux sur le résultat.
Pour ma troisième tentative, j’ai configuré l’Avalonia Build MCP, qui permettait au LLM d’aller chercher efficacement la documentation des API, et j’ai instrumenté l’application pour qu’elle soit utilisable avec l’Avalonia DevTools MCP. J’avais maintenant un usage exact des API Avalonia, mais surtout, le LLM pouvait lancer l’application Avalonia pour interagir avec elle, et inspecter le résultat visuel d’une façon qui ressemble de près au serveur MCP Playwright pour les applications web. Je l’ai laissé tourner plus de 24 heures tout seul, en disant essentiellement à GitHub Copilot de continuer. Au final, j’avais une première version fonctionnelle et utilisable d’UniGetUI en Avalonia, assez proche de l’originale en WinUI.
C’est ce que j’ai remis au nouveau développeur que nous avions assigné à temps plein sur UniGetUI. Avec quelques semaines de plus d’ajustements et de corrections par quelqu’un qui savait mieux que moi travailler avec Avalonia, nous avons enfin obtenu quelque chose de correct. Comme changer de framework d’interface est quelque chose auquel les utilisateurs sont particulièrement sensibles, il a fallu environ deux mois avant d’atteindre le point où nous pouvions supprimer la version WinUI d’origine et ne garder que la nouvelle interface Avalonia.
Rembourser la dette technique
Devolutions Server est une application ASP.NET qui utilise SQL Server sans ORM. C’est ainsi depuis le début, et comme il y a beaucoup d’héritage, nous ne pouvons pas « simplement » ajouter la prise en charge d’une autre base de données comme PostgreSQL. Pour empirer les choses, la seule personne dans l’entreprise qui connaît cette partie délicate de l’application est sur le point de prendre sa retraite (c’est notre ancien CTO). Quand Fable 5 est sorti le 9 juin, j’y ai vu l’occasion parfaite d’essayer la migration vers PostgreSQL, parce que bientôt ce savoir pointu sur cette dette technique ne serait plus disponible.
J’ai soigneusement créé un plan dans GitHub Copilot avec Fable 5, puis j’ai lancé l’agent. J’ai réussi à le faire fonctionner à un niveau fonctionnel minimal dans les premières 24 heures. J’ai ensuite fait une analyse des écarts exhaustive pour trouver les trous à corriger, généré un nouveau plan avec une meilleure couverture de tests, et plus de tests de bout en bout. J’ai fait utiliser à GitHub Copilot son canevas de navigateur pour charger l’application web, se connecter avec un utilisateur de test, cliquer un peu partout et valider que cela fonctionnait vraiment. Je lui ai même fait passer des tests qui impliquaient d’attendre l’exécution de tâches planifiées. Le soir du 12 juin, quand une directive américaine de contrôle des exportations a forcé Anthropic à retirer Fable 5 pour tout le monde, trois jours seulement après sa sortie, j’avais terminé le gros du travail.
Même si je n’avais pas une compréhension approfondie des bases de données ni de cette partie de l’application, j’avais à ce stade affiné mon habileté à faire de grandes migrations complexes avec l’IA. J’ai utilisé une analyse des écarts détaillée et exhaustive pour comprendre ce qu’il fallait faire, ce qu’il fallait corriger, ce qui ne se comportait pas comme l’original. J’ai généré des plans pour ajouter des tests unitaires, mais aussi des tests d’intégration, et j’ai combiné cela avec des tests de bout en bout où l’agent d’IA interagissait avec l’application. Ce que j’ai produit était utile et démontré fonctionnel jusqu’à un certain point, mais pas encore révisé en profondeur.
Voici où cela devient intéressant : je ne me suis jamais autant amusé avec notre ancien CTO que durant la dernière année. Il a été très impressionné par les progrès, et il s’est mis à corriger avec Claude Code les choses qu’il pouvait trouver. Je lui ai remis ma branche après l’avoir amenée au niveau que je pouvais atteindre, et il a pris le relais, avec une perspective que je n’avais pas. Il a fallu quelques semaines pour vraiment trouver tous les problèmes subtils qui restaient, mais nous avons fait une très bonne équipe, et nous avons mené cela à terme.
Ma recommandation, quand il s’agit de rembourser la dette technique dans les zones à haut risque du code, est de ne pas lésiner sur les jetons. Utilisez les plus gros modèles et lancez beaucoup de révisions ciblées pour faire ressortir les différents types de problèmes que vous craignez de voir arriver. Il est très facile de faire fonctionner les choses, mais il faut beaucoup plus de temps et d’efforts pour les faire correctement.
Comment les revues de code ont changé
Est-ce que des humains révisent chaque ligne de code ? Non, parce que cela ne passe pas à l’échelle. Personne ne peut réviser un flux constant d’énormes pull requests tout en restant assez concentré pour attraper tous les problèmes. La bonne nouvelle, c’est qu’un agent d’IA ne se fatigue jamais d’attraper des problèmes. Les revues de code chez Devolutions consistaient souvent à expliquer vos changements à un collègue, qui posait des questions en retour. Avec l’IA, vous pouvez faire une première révision locale de vos changements, puis faire faire une seconde révision par un autre agent d’IA quand vous ouvrez la pull request.
Voici une anecdote amusante sur la revue de code de GitHub Copilot : quelqu’un s’est déjà « plaint » qu’il trouvait sans cesse des problèmes sur ses pull requests et, comme c’étaient de vrais problèmes, il ne pouvait pas les contester. Si tous ces problèmes existent dans le code, pourquoi ne peut-il pas en signaler 50 d’un coup, au lieu de 10 à la fois ? Le vrai agacement, c’était de boucler jusqu’à ce que la revue de code par l’IA cesse de trouver de vrais problèmes à corriger.
Pour les changements dont le rayon d’impact est potentiellement grand, nous avons normalement quelqu’un qui porte une attention plus soutenue aux changements. Au lieu de passer ligne par ligne dans l’interface web de GitHub, nous avons trouvé beaucoup plus efficace de simplement récupérer la branche localement pour poser à l’IA les questions que vous auriez normalement posées à l’auteur de la pull request. Vous pouvez déverser toutes vos préoccupations et attendre que l’IA valide si les changements correspondent à vos attentes. Il est aussi plus facile de demander à l’IA d’expliquer comment les changements ont été faits, quelles parties de l’application ils touchent, et comment. Vous pouvez ensuite simplement demander à l’IA de soumettre les constats comme commentaires en ligne sur la pull request.
Pour éviter d’« approuver machinalement » les pull requests, nous avons actuellement un projet pilote d’approbations automatiques de pull requests par l’IA si les changements correspondent à certains critères. Il ne sert à rien d’attendre qu’un humain appuie sur un bouton si le rayon d’impact n’est pas critique.
Déployer l’IA à l’échelle de Devolutions
L’explosion des outils d’IA
En janvier 2026, nous avions une équipe interne de champions de l’IA, dont le rôle était de promouvoir l’usage de l’IA en partageant leur propre expérience avec leurs pairs. Les instructions destinées à l’IA étaient maintenues par quelques développeurs dans le monorepo. Le message envoyé à tout le monde était de mettre à jour les instructions destinées à l’IA pour qu’elle comprenne mieux le code, au lieu de résister à l’IA et de se plaindre qu’elle faisait trop d’erreurs. À l’interne, la plupart des développeurs utilisaient Claude Code, et de plus petits groupes utilisaient GitHub Copilot, Cursor ou Codex. Nous avions deux comités d’IA : un comité de direction avec la haute direction, pour discuter des initiatives d’IA de plus haut niveau ou des projets d’IA fondateurs, et un comité « centre d’excellence » de l’IA avec les champions de l’IA, plus concret, plus opérationnel.
La tentation est là d’essayer de normaliser les outils d’IA que nous offrons, mais nous y résistons. Les développeurs ont leurs propres préférences et nous ne voulons pas les forcer à utiliser un outil qu’ils n’aiment pas. Personnellement, je n’ai jamais aimé Claude Code et je suis passé à fond à GitHub Copilot. Je ne peux pas contester quelqu’un qui se sent productif dans un outil que je n’utiliserais pas moi-même, même si je ne peux pas l’expliquer rationnellement. Ma théorie, c’est que le gain de productivité des outils d’IA est si grand que la comparaison se fait avec les outils d’avant l’IA, pas entre les outils d’IA. Dès que quelqu’un se sent efficace avec un outil d’IA qui correspond à son modèle mental et à son flux de travail, il voudra s’y tenir. J’étais un grand utilisateur de VS Code avant l’IA, alors je suis naturellement allé d’abord vers GitHub Copilot. Beaucoup de développeurs préfèrent utiliser Claude Code dans un terminal à côté de leur IDE principal (Visual Studio ou JetBrains), et voient VS Code comme un IDE de plus à côté de celui qu’ils ont déjà.
Nous avons connu la première « interruption » d’IA quand nous avons atteint une limite mensuelle de 5 000 $, ce qui nous a obligés à mettre à niveau notre compte chez Anthropic pour continuer. Pendant quelques jours, certains utilisateurs de Claude Code sont passés temporairement à GitHub Copilot, le temps que la question de la limite sur notre compte soit réglée. Ces chiffres paraissaient gros à l’époque, pour toute l’entreprise. Aujourd’hui, c’est simplement ce qu’un seul utilisateur intensif peut facilement consommer. GitHub Copilot utilise encore le modèle de requêtes premium qui le rendait incroyablement peu coûteux si vous saviez comment l’utiliser efficacement. Cursor est plus cher, mais nous avons commencé à l’offrir à nos développeurs web et au service du marketing à cause de ses capacités agentiques de navigateur intégrées, plus avancées.
Un effet secondaire de l’explosion des nouveaux outils d’IA est que notre processus de gestion des fournisseurs est vite devenu un goulot. Avec un nouvel outil d’IA intéressant qui sort chaque jour, et un message clair du PDG selon lequel nous passons à fond à l’IA, le nombre de demandes pour évaluer de nouveaux produits de divers fournisseurs a dépassé ce que nos équipes juridiques et de sécurité pouvaient traiter dans des délais raisonnables. Même si vous arriviez à traverser tout le processus pour faire approuver l’outil, qu’en est-il des nouvelles fonctions qui devraient probablement être évaluées de nouveau, comme les fonctions de bac à sable infonuagique ? Et les nouveaux modèles d’IA qui sortent, mais qui sont servis par un nouveau fournisseur d’inférence qui n’était pas utilisé lors de l’évaluation d’origine ? Nous avons simplifié notre processus, mais c’est encore un problème aujourd’hui.
La grande guerre des fichiers Markdown de l’IA
Vous souvenez-vous de l’époque où les agent skills et AGENTS.md n’existaient pas encore, et où chaque outil utilisait une convention différente pour les fichiers Markdown ? J’aime appeler cela la « grande guerre des fichiers Markdown de l’IA » : noms de fichiers, chemins, formats différents, etc. À moins de vous être normalisé sur un seul outil d’IA, vous étiez voué à frapper le problème des incompatibilités. GitHub Copilot utilisait .github/copilot-instructions.md, Claude Code utilisait CLAUDE.md, avec un possible emboîtement. Des « commandes slash » réutilisables et des instructions propres à un chemin. Tous n’étaient lisibles que par leurs propres outils, jusqu’à ce que les skills de Claude deviennent des agent skills que la plupart des outils adoptaient et lisaient aux mêmes chemins, tous sauf Claude. AGENTS.md est devenu la nouvelle norme, que Claude, encore une fois, ne lisait pas, et qui exigeait plutôt CLAUDE.md.
Nous avons d’abord écrit des scripts pour synchroniser et adapter les agent skills et les fichiers Markdown pour la compatibilité dans notre monorepo, avec une tâche de CI qui les exécutait chaque fois que l’un des fichiers était modifié, mais cela rendait difficile d’itérer localement sur la mise à jour des instructions. Nous sommes finalement passés à des liens symboliques git, qui sont un vrai casse-tête à utiliser sur Windows, parce que les liens symboliques exigent une configuration spéciale pour être correctement activés. Nous avons commencé à sortir les instructions du AGENTS.md et du CLAUDE.md principaux vers de plus petits fichiers Markdown, et à extraire les flux de travail réutilisables dans leurs propres agent skills. Vous vous souvenez de cet énorme fichier Markdown de 5 000 lignes pour les migrations Avalonia ? Il a été découpé en beaucoup de plus petits agent skills, et les conventions propres à chaque plateforme ont été extraites dans leurs propres fichiers Markdown.
De nouveaux skills continuent d’être ajoutés au monorepo principal de Devolutions : plus de 25 concernent à eux seuls des tâches liées à Avalonia. Des agent skills ont été ajoutés pour modifier les fichiers de traduction. La version d’origine de ces skills amenait naïvement le LLM à lire de très gros fichiers .resx juste pour changer une ligne. Ils ont ensuite été réécrits et optimisés pour utiliser un script d’aide, ce qui a fait passer le coût d’une modification de 1 $ à quelques centimes, parce que le LLM n’avait plus besoin de lire tout le fichier, seulement la ligne qu’il voulait modifier.
Le hackathon des agent skills
Pourtant, la plupart des agent skills étaient encore écrits par une poignée de personnes dans l’entreprise, un problème récurrent qui revenait dans nos comités d’IA. La solution que nous avons trouvée a été d’organiser en mars un hackathon « agent skill » d’IA à l’échelle de l’entreprise, pour les développeurs. Nous avions tenu beaucoup de hackathons par le passé, mais l’intérêt avait diminué ces dernières années, avec moins de participants. Il était temps de faire quelque chose de nouveau, avec un format différent, pour briser la « fatigue des hackathons » qui s’était installée.
J’ai pris le temps d’amorcer un dépôt dédié aux agent skills, que les développeurs pouvaient simplement cloner et ouvrir dans l’outil de leur choix, avec un README.md et quelques agent skills déjà présents pour démarrer. J’ai rédigé un bon AGENTS.md, avec des références faisant autorité à utiliser pour écrire des agent skills, et des instructions pour utiliser des scripts PowerShell multiplateformes aux côtés de SKILL.md pour les scripts d’aide. Les TI avaient préinstallé PowerShell 7 sur toutes les machines, en s’assurant que les utilisateurs de macOS, de Linux et de Windows pourraient utiliser ces agent skills dès le départ.
Dans les semaines avant le hackathon, nous avons fait diverses annonces pour encourager les participants à réfléchir à ce qu’ils aimeraient faire, et à ajouter d’avance leur nom et leur idée de projet dans un canevas Slack visible par tout le monde. Nous avons lancé la journée du hackathon par un court appel conférence dans lequel j’ai présenté le dépôt git à utiliser, montré quelques agent skills d’exemple, comment démarrer et où trouver des instructions plus détaillées. Le but était simple : cloner ce dépôt, écrire un agent skill pour n’importe quoi que vous voulez, et soumettre une pull request quand vous avez terminé. Ne vous inquiétez pas de faire le meilleur agent skill ni le plus complexe. Concentrez-vous sur le fait d’en terminer au moins un. À la fin du hackathon, tout le monde se sentirait à l’aise d’écrire ses propres agent skills, plus d’excuses. Les agent skills qui devaient être dans un projet précis pour fonctionner pouvaient être développés dans un autre dépôt, tant qu’une copie était faite dans le dépôt git dédié au hackathon pour la soumission de la pull request.
Cette approche d’un seul dépôt git pour le hackathon a vraiment aidé à donner le sentiment que tout le monde travaillait sur la même chose, en collaboration, au lieu que chacun reste dans son propre projet séparé. Il y avait beaucoup d’activité dans le canal Slack du hackathon, les participants partageant des liens vers leurs propres pull requests ou posant des questions. C’était de loin le hackathon le plus réussi que nous ayons eu depuis des années et, à la fin, 60 agent skills avaient été contribués.
Étendre l’IA au-delà des développeurs
Le succès du hackathon « développeurs » a été si grand qu’il a mené à l’organisation d’un hackathon « no-code » en mai. Nous avons un peu adapté le format, surtout pour les outils, qui sont passés à ChatGPT ou Claude, en acceptant les GPT personnalisés et d’autres formes d’instructions d’agent d’IA personnalisées qui fonctionnent le mieux dans les agents conversationnels. Des salles de conférence ont été réservées pour la journée, avec des organisateurs qui se rendaient disponibles pour aider. Beaucoup de personnes qui ne sont pas développeurs ont vraiment apprécié de pouvoir avoir un expert qui prenait le temps de les aider à accomplir des choses dont elles ne se savaient même pas capables.
N’oublions pas que, même dans une entreprise de développement logiciel, une énorme partie de l’activité repose sur des personnes qui ne sont pas développeurs, et elles doivent aussi faire partie de la transformation par l’IA. En tant que développeurs, le fossé entre les outils d’IA pour développeurs et ceux pour les autres est plus évident pour nous qu’il ne l’est pour les personnes qui ne sont pas développeurs quand elles regardent nos outils. Avec l’invite comme nouvelle interface d’utilisateur, y a-t-il un moyen de configurer des outils de développement pour qu’ils soient utilisés par notre équipe de marketing produit ? La réponse, il s’avère, est oui !
Pour le contexte, beaucoup de demandes internes à notre équipe de marketing produit consistent à mettre à jour ou à modifier le site web, les changements étant faits par l’équipe marketing web. Nous avions déjà intégré Cursor pour les développeurs web à cause de son navigateur intégré, qui ressemble à « Inspecter l’élément » de Chrome, mais infiniment plus puissant. J’ai amorcé un nouveau dépôt git semblable à celui du hackathon, et j’ai écrit un ensemble d’agent skills qui permettaient d’aller chercher et de refléter n’importe quel site web facilement, de façon que Cursor puisse modifier des sites statiques et produire des maquettes. Fini Figma et les nombreux allers-retours : vous pouviez simplement modifier le vrai site web en formulant une invite, et j’ai même ajouté un agent skill pour exporter le site statique modifié localement vers un seul fichier .htm.
Cela a permis des itérations beaucoup plus rapides, avec une copie du vrai site web avec laquelle on pouvait interagir, ce qui est très différent des captures d’écran, ou même des maquettes interactives qui simulent le site sans vraiment s’appuyer sur lui. Cela a nettement réduit le nombre de passages de relais et les longs processus pour modifier le site web. Mieux encore, le développeur pouvait maintenant fournir à Cursor le site statique modifié exporté pour que les changements soient faits correctement dans le code source à partir duquel le site est construit.
Aujourd’hui, cette équipe est l’une des plus avancées dans l’adoption de l’IA, et elle peut déclencher des modifications du site web en mentionnant le bot Cursor dans une conversation Slack. Le site est modifié, construit et déployé temporairement, avec un lien qu’il suffit d’ouvrir pour voir si les changements sont bons. S’ils sont approuvés, ils sont fusionnés et déployés automatiquement. Ce serait bien sûr beaucoup plus difficile pour des applications de bureau et mobiles comme Remote Desktop Manager, mais si ce que vous développez utilise une pile web, vous avez l’avantage de pouvoir fermer la boucle beaucoup plus facilement dans des environnements infonuagiques en bac à sable.
La nouvelle économie de la création de logiciels
Embaucher sans faire croître l’effectif
Nous n’avons pas eu de licenciements de masse liés à l’IA chez Devolutions. À la place, nous avons offert des indemnités de départ volontaire. À l’automne 2025, seuls quelques employés ont décidé de les accepter. Nous ne voulions pas que des employés se sentent pris au piège dans une « Devolutions 2.0 » qui pourrait ne plus leur convenir. En 2026, nous avons offert de généreuses indemnités de préretraite, acceptées par la plupart des employés admissibles. Même si l’année n’est pas encore terminée, nous sommes en voie d’avoir un nombre équilibré de départs et de nouvelles embauches, de sorte que l’effectif total reste le même. Nous n’avons pas cessé d’embaucher, mais nous avons cessé de remplacer. L’IA a été un facteur important dans la redistribution de la main-d’œuvre : chaque nouvelle embauche appuie la nouvelle Devolutions, tandis que chaque départ nous éloigne davantage de l’ancienne Devolutions.
Une foule de nouveaux projets d’IA
Pour la seule année 2026, j’ai créé de zéro un grand nombre de nouveaux projets majeurs, tous avec l’application GitHub Copilot. Mon portable est maintenant en permanence éveillé, et il fait tourner des agents la plupart du temps. Quand je rentre à la maison, je le branche et je relance mes sessions. Avant de dormir, je m’assure que mes sessions ne sont pas inactives, et je les envoie sur des tâches de nuit. Quand je me réveille le matin, je les relance souvent, et le temps que je parte pour le bureau, elles ont déjà progressé. Je suis certain que d’autres CTO vivent la même chose : le temps est une monnaie avec les agents d’IA de longue durée. Tout ce temps mort où vous n’êtes pas devant l’ordinateur peut soudain devenir productif.
Je ne suis pas encore tout à fait certain que ce soit sain à long terme, mais c’est la nouvelle réalité à laquelle j’essaie de m’adapter. J’ai toujours eu beaucoup plus d’idées ambitieuses que de temps et de ressources pour les réaliser, alors c’est très excitant et très épuisant en même temps. Dans le passé, j’étais contraint par le fait que je ne pouvais pas retirer des ressources critiques pour construire un projet parallèle sur un coup de tête. Maintenant, cela se résume au temps que je peux passer à préparer un plan pour lancer un agent. Combinez cela avec un budget de jetons illimité, et j’ai construit plus de logiciels ces derniers mois que dans toute ma vie.
Voici une courte liste d’expériences qui ont assez bien fonctionné pour que je les nettoie en vue d’une vraie publication. Elles sont toutes utilisées en production, soit comme outils, soit comme composants de l’un de nos produits :
- Pinget : ports C# et Rust de winget-cli (C++), rendus multiplateformes. Offert comme paquet NuGet pour être consommé dans UniGetUI.
- psign : outil de signature de code multiplateforme en Rust qui prend en charge tous les formats de fichiers Authenticode, avec prise en charge d’Azure Key Vault et d’Azure Artifact Signing.
- windbg-tool : outil en ligne de commande en Rust qui utilise le moteur WinDBG, conçu précisément pour permettre aux agents d’IA d’inspecter des vidages de processus, et que j’ai utilisé pour enquêter sur des BSOD sur mon portable.
Tous ces projets massifs ont été terminés en quelques semaines, pour une petite fraction du coût qu’ils auraient eu dans le passé. Historiquement, je ne pouvais choisir que quelques-unes de ces idées et planifier le travail sur plusieurs mois ou années pour que d’autres le fassent. Je pense que c’est pourquoi beaucoup de dirigeants aiment autant l’IA : si vous avez l’habitude de déterminer très précisément ce que vous voulez que les autres construisent, selon vos exigences, parler à un agent d’IA vous semblera très naturel.
Je brûle maintenant un minimum de 15 000 $ par mois dans GitHub Copilot. Cela peut sembler beaucoup, mais ce n’est encore vraiment rien comparé au fait de déléguer ce genre de travail à une équipe de développeurs à temps plein. Non seulement c’est moins cher, mais vous pouvez habituellement évaluer la faisabilité dans les premières 24 heures, et abandonner tôt les expériences vouées à l’échec. Dans le passé, les ressources étaient mobilisées beaucoup plus longtemps avant de frapper un obstacle rédhibitoire imprévu.
Créer des logiciels pour l’IA, pas seulement avec l’IA
L’IA peut écrire beaucoup de code rapidement, mais on ne devrait le considérer comme bon qu’après avoir confirmé qu’il s’exécute correctement au moins une fois. Les tests sont la façon la plus simple d’exécuter du code pour s’assurer qu’il correspond au comportement attendu, mais tout n’est pas facile à tester. Beaucoup de parties d’une application peuvent être difficiles à automatiser ou exiger un environnement réel précis. La bonne nouvelle, c’est que l’IA peut maintenant vous aider à atteindre de hauts niveaux de testabilité beaucoup plus facilement qu’avant.
Au-delà des tests, vous devriez investir dans la construction d’outils conçus précisément pour un agent d’IA. À l’époque de FreeRDP, je me souviens encore des longues heures passées à faire un changement, compiler, lancer une commande pour me connecter à une machine virtuelle Windows, cliquer et taper quelque chose pour déclencher une fonction RDP précise sur laquelle je travaillais, et voir si cela fonctionnait. Et on recommence, encore et encore.
Avançons jusqu’à aujourd’hui avec IronRDP, le successeur spirituel de FreeRDP, écrit en Rust plutôt qu’en C. C’est un effort de plusieurs années que j’ai commencé chez Devolutions bien avant l’IA, en connaissant très bien l’effort gigantesque requis. Le projet est très actif, avec beaucoup de contributeurs internes et externes. Vu ce que l’IA pouvait faire, j’ai entrepris de construire un client RDP agentique avec un seul but en tête : faire faire à mon agent d’IA la partie ennuyeuse et répétitive que je faisais manuellement.
La stratégie est simple : ironrdp-agent lance un processus démon pour la connexion de bureau à distance, qui peut être contrôlé par des appels IPC répétés depuis la CLI. L’agent d’IA peut alors prendre des captures d’écran, interagir avec le bureau en cliquant et en tapant, utiliser le presse-papiers, exécuter des scripts, copier des fichiers, etc. Cela veut dire que je peux faire passer des heures à mon agent d’IA à faire le travail ingrat de tester de façon exhaustive des fonctions qui exigeaient autrefois une interaction humaine, pendant que je dors.
Qui n’aime pas se réveiller le matin devant une longue liste de cas de test « manuels » confirmés comme fonctionnels ? C’est ainsi que j’ai ajouté la redirection du système de fichiers pour Windows dans IronRDP. L’agent a copié des structures complexes de fichiers et de répertoires, et vérifié les empreintes des fichiers avant et après. Il a même copié une image ISO de 8 Go pour confirmer qu’il pouvait transférer des fichiers de plus de 4 Go sans les corrompre.
La nouvelle réalité économique de l’IA signifie qu’il y a un très haut rendement sur l’investissement à construire des outils destinés précisément aux agents d’IA. En plus, développer ces outils coûte moins cher qu’avant, alors vous n’avez pas à choisir. Avec le développement traditionnel, le coût de construire des outils de développement complexes dépassait souvent les gains de productivité.
La suite
Fermer la boucle de rétroaction des applications de bureau Windows
La migration Avalonia de RDM Windows n’a pas tiré parti d’une boucle de rétroaction complète avec l’agent d’IA, mais cela a été compensé par des développeurs qui itéraient vite sur la phase de validation. La migration Avalonia d’UniGetUI a été faite surtout avec une boucle de rétroaction fermée avec l’agent d’IA pendant 24 heures, suivie de quelques semaines de corrections faites par un développeur. La partie que je ne vous ai pas dite, c’est que la seule façon efficace de fermer la boucle de rétroaction sur une application de bureau Windows, en ce moment, est de laisser l’agent d’IA prendre le contrôle de l’ordinateur.
Si vous installez la CLI winapp et les agent skills associés pour l’automatisation de l’interface dans l’application GitHub Copilot, vous pouvez faire lancer votre application par l’agent d’IA et interagir avec elle de la même façon qu’il le ferait avec une application web qui tourne dans Playwright. Le seul problème, c’est que Windows ne prend en charge qu’une application ayant le focus d’entrée à la fois, alors vous ne pouvez pas vraiment faire autre chose pendant que l’agent d’IA contrôle l’ordinateur. C’est pourquoi je laissais souvent tourner la nuit de longues tâches de validation d’interface, quand je n’étais pas devant l’ordinateur.
Le défi de l’année qui vient sera de fermer la boucle de rétroaction des applications de bureau Windows d’une façon qui permette aux agents d’IA de lancer et de tester des interfaces graphiques sans rien interrompre. Un environnement complet de bureau à distance pourrait fonctionner, mais il exige beaucoup d’outils supplémentaires pour prendre en charge le déploiement et l’exécution à distance. Quant à Windows Sandbox, c’est encore du RDP sous le capot, mais il est malheureusement limité à une seule connexion à la fois, alors des sessions concurrentes ne seraient pas possibles.
Avec mon statut de Microsoft MVP, je peux fournir une rétroaction directe à Microsoft, et j’espère trouver une solution à ce problème, peut-être en contribuant une partie de la solution technique avec IronRDP. Ce sera un domaine d’attention pour l’année qui vient, vu les gains de productivité que cela débloquerait avec les agents d’IA pour nous.
Mes prédictions pour l’année qui vient
Cette dernière année a été si chargée qu’elle m’a semblé durer une décennie. Tellement de choses qui paraissaient naïvement ambitieuses dans un passé récent sont devenues assez faciles à réaliser ces derniers mois. Je ne pense pas que nous soyons près de voir l’IA atteindre un plateau : elle continue simplement d’accélérer à un rythme étourdissant. J’ai récemment ressenti un profond malaise après avoir terminé en quelques heures quelque chose pour lequel on m’avait donné une estimation de 4 mois de travail avec des méthodes de développement traditionnelles.
Les flux de travail agentiques sans humain dans la boucle deviendront plus courants : beaucoup plus de flux seront déclenchés automatiquement plutôt que manuellement, et ils accompliront plus d’actions sans humain dans la boucle. Par exemple, mettre à jour automatiquement la documentation pour qu’elle corresponde au code source d’un produit. Trouver automatiquement des problèmes de sécurité et ouvrir une pull request avec un correctif provisoire. Les humains resteront souvent dans la boucle quelque part, mais à moins d’endroits.
Les dépenses d’IA deviendront une part permanente et importante du budget d’une entreprise : il y a quelques mois, nous étions en voie de 1 million de dollars par année d’après les coûts mensuels, mais cela a depuis grandi jusqu’à 2 millions de dollars par année. Nous n’avons toujours aucun plan pour réduire nos dépenses d’IA. Gardez à l’esprit qu’il s’agit d’une entreprise de 250 employés, donc environ 8 000 $ par employé. Je m’attends à ce que ce chiffre ne fasse que continuer de croître, même une fois que nous déciderons d’essayer d’optimiser les coûts.
Ce qui n’a pas changé
Dans un monde qui change si vite, quelles vérités demeurent ?
Trouver et configurer les bons outils pour le travail compte encore : vous voulez faire de la rétro-ingénierie d’un logiciel écrit en C/C++ ? Prenez le temps d’installer Ghidra ou IDA Pro, et de configurer un serveur MCP pour exposer ses fonctions à votre agent d’IA. Sinon, vous conduirez essentiellement une voiture rapide avec des pneus à plat : elle n’ira nulle part, et vous gaspillerez beaucoup de jetons à essayer.
Une connaissance approfondie de l’architecture logicielle reste pertinente : ne confondez pas le fait d’avoir atteint un but avec le fait de l’avoir fait de la bonne façon. L’IA est très bonne à faire ce que vous demandez, mais si vous n’avez qu’une compréhension de surface, vous laissez beaucoup de décisions importantes au pur hasard. La compréhension profonde est ce qui vous aide à orienter l’IA dans la bonne direction, pour qu’elle ne prenne pas de raccourcis qui pourraient entrer en conflit avec les exigences que vous visez.
Construire la maison avant les fondations reste une mauvaise idée : une bonne partie de l’effort de migration Avalonia est allée à construire de vrais composants qui pouvaient être réutilisés à plusieurs endroits. Si nous avions poussé les migrations qui en dépendaient, l’agent d’IA aurait créé beaucoup de code passe-partout et d’aides très semblables. Construire de vraies fondations sous une maison déjà construite, c’est faisable, mais cela coûte beaucoup de jetons et de temps.
Leçons apprises
J’ai beaucoup appris au cours de la dernière année, mais si je devais le réduire à une courte liste, la voici :
- L’exécution est compressée : il y a plus de valeur à savoir quoi faire qu’à le faire
- Vous devriez rembourser activement la dette technique pour retrouver l’agilité perdue
- Investissez dans des outils qui permettent aux agents d’IA de fermer la boucle de rétroaction
- Les revues de code existent encore, mais elles se font maintenant avec l’IA, à différents niveaux
- Modifier du code que vous ne comprenez pas peut accélérer le développement
J’espère que mon expérience comme CTO de Devolutions durant cette dernière année d’IA a été pertinente pour votre réalité sur le terrain, et que vous en avez appris quelque chose. J’ai hâte à l’année prochaine, sur ces montagnes russes sans fin !